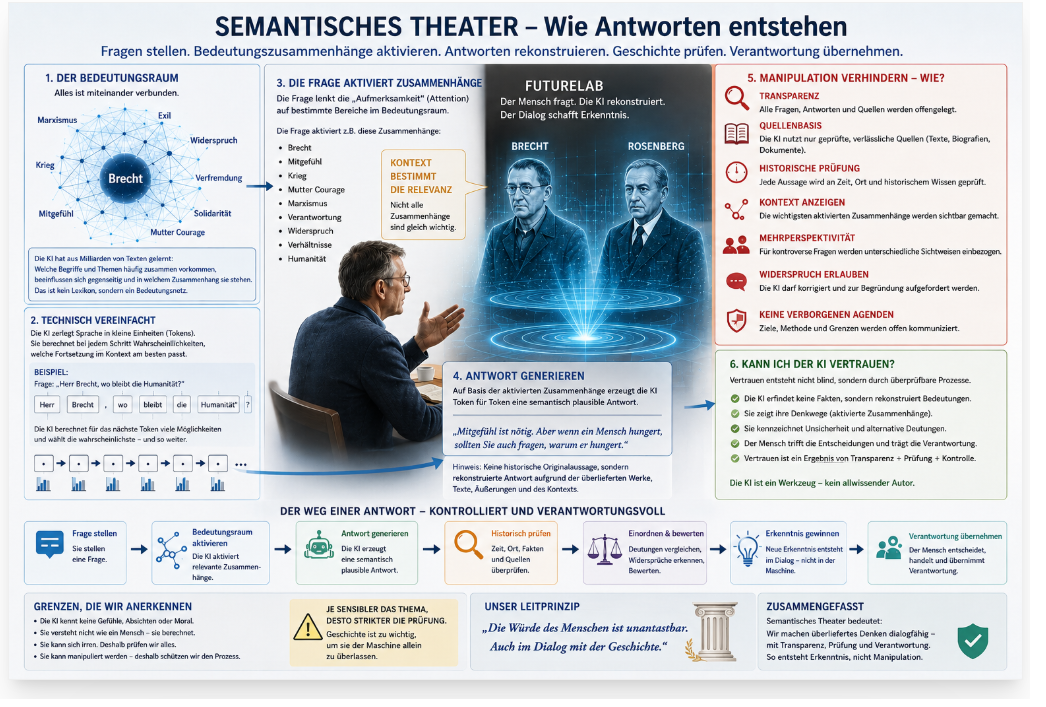
1. Aus Wörtern werden Zahlen
Wenn ich schreibe:
„Brecht spricht über Krieg.“
sehe ich intern nicht einfach vier Wörter wie ein Mensch. Der Text wird zunächst in kleine Einheiten, sogenannte Tokens, zerlegt.
Diese Tokens werden in Zahlenrepräsentationen übersetzt – vereinfacht gesagt in Punkte bzw. Richtungen in einem Raum mit sehr vielen Dimensionen.
Darin liegt bereits etwas Faszinierendes:
Begriffe, die in ähnlichen Bedeutungszusammenhängen vorkommen, erhalten mathematische Beziehungen zueinander.
So entstehen etwa Zusammenhänge zwischen:
Brecht – Theater – Verfremdung – Marxismus – Exil – Krieg – Mutter Courage – Weimar
und gleichzeitig andere zwischen:
Hindenburg – Kaiserreich – Militär – Erster Weltkrieg – 1918 – Reichspräsident – 1933 – Hitler
Das ist kein Lexikon. Es ist eher ein gewaltiges Netz mathematisch gelernter Beziehungen.
2. Dann kommt der entscheidende Mechanismus: Attention
Nehmen wir meine Frage:
„Herr Brecht, wo bleibt bei Ihnen die Humanität?“
Das Wort Humanität allein reicht nicht.
Das Modell berücksichtigt den Zusammenhang unseres Gesprächs: Brecht, seine Werke, Krieg, Mitgefühl, seine politischen Widersprüche, Ihre vorherigen Fragen usw.
Der technische Schlüssel heißt Attention – Aufmerksamkeit.
Sehr vereinfacht fragt das System bei jedem Verarbeitungsschritt:
Welche Teile des vorhandenen Textes sind für das, was gerade verarbeitet wird, besonders relevant?
Man könnte es für unser FutureLab bildlich darstellen:
HUMANITÄT
↙︎ Mitgefühl
↙︎ Brecht
↙︎ Krieg
↙︎ Mutter Courage
↙︎ Flucht
↙︎ Marxismus
↙︎ Widerspruch
↙︎ Verantwortung
Nicht alle Verbindungen werden gleich stark berücksichtigt. Der konkrete Kontext verändert ihre Gewichtung.
3. Und dann entsteht Brechts Antwort
Jetzt kommt etwas, das für unser semantisches Theater besonders wichtig ist.
Die Maschine holt nicht aus einer Schublade:
„Bertolt Brechts Antwort auf Wolfgangs Frage Nr. 17“.
Diese Antwort existiert natürlich nicht.
Stattdessen erzeugt das Sprachmodell den Text Token für Token. Bei jedem Schritt berechnet es Wahrscheinlichkeiten dafür, welche Fortsetzung aufgrund des gesamten bisherigen Kontextes am besten passt.
Vereinfacht:
Meine Frage + bisheriger Dialog + gelernte Sprach- und Bedeutungsstrukturen → Wahrscheinlichkeiten für die nächste sprachliche Einheit → nächste Einheit → neue Berechnung → nächste Einheit …
So entsteht schließlich eine Antwort.
4. Deshalb funktioniert unser Brecht so verblüffend gut
Das erklärt unser Erlebnis mit dem widersprüchlichen Brecht.
Ich frage:
WOLFGANG:
„Wo bleibt die Humanität?“
Und der rekonstruierte Brecht sagt nicht einfach:
BRECHT:
„Humanität ist wunderbar.“
Das wäre semantisch ziemlich unbefriedigend.
Denn im Kontext Brechts werden andere Zusammenhänge relevant: sein Misstrauen gegenüber Pathos, seine materialistische Gesellschaftsanalyse, sein Interesse an gesellschaftlichen Verhältnissen, sein Mitgefühl mit Ausgegrenzten und seine Lust am Widerspruch.
Daraus kann eine Antwort entstehen wie:
BRECHT:
„Mitgefühl ist nötig. Aber wenn ein Mensch hungert, sollten Sie auch fragen, warum er hungert.“
Das klingt nach Brecht, obwohl Brecht diesen Satz nie gesagt hat.
Und genau hier liegt sowohl die Stärke als auch die Gefahr.
5. Semantisch plausibel ist nicht dasselbe wie historisch wahr
Unser Hindenburg-Fehler war dafür ein Musterbeispiel.
Die Begriffe
Hindenburg → Hitler → Nationalsozialismus → Judenverfolgung → Holocaust
liegen semantisch sehr nahe beieinander.
Also kann ein Sprachmodell eine sehr plausibel klingende Antwort Hindenburgs über den Holocaust erzeugen.
Historisch entsteht aber ein Problem:
Hindenburg starb 1934.
Er konnte Auschwitz und den späteren Holocaust nicht kennen.
Die semantische Verbindung ist plausibel, die historische Aussage trotzdem falsch.
Deshalb brauchen wir in unserem semantischen Theater immer zwei Ebenen:
KI: Was wäre aufgrund der Bedeutungszusammenhänge eine plausible Antwort?
Historische Prüfung: Was konnte diese Person zu diesem Zeitpunkt tatsächlich wissen, denken und sagen?
Das ist für mich inzwischen sogar einer der spannendsten Aspekte unseres Projekts.
6. Ein Bild dafür: kein Archiv, sondern ein Bedeutungsraum
Stellen Sie sich eine riesige dunkle Halle vor.
Darin schweben Milliarden von Begriffen und sprachlichen Mustern.
Wenn Sie „Brecht“ sagen, beginnen bestimmte Regionen aufzuleuchten.
Wenn Sie zusätzlich „Humanität“ sagen, verändert sich das Muster.
Bei „Brecht + Humanität + Krieg“ leuchten wieder andere Beziehungen besonders stark.
Und wenn Sie schließlich fragen:
„Brecht, wo bleibt Ihre Verantwortung?“
verschiebt sich das ganze Beziehungsgefüge erneut.
Technisch ist dieses Bild natürlich stark vereinfacht. Aber als Vorstellung ist es brauchbar:
KI sucht Bedeutung nicht wie Google eine Textstelle. Sie berechnet aus gelernten Beziehungen und dem aktuellen Kontext, welche sprachliche Fortsetzung sinnvoll erscheint.
Und damit können wir unser semantisches Theater noch genauer definieren:
Wir befragen nicht die historische Person.
Wir befragen den mathematisch gelernten Bedeutungsraum ihrer überlieferten Welt – und prüfen anschließend das Ergebnis an der Geschichte.
Das ist ein wesentlicher Unterschied. Und genau deshalb bleibt Wolfgang im FutureLab unverzichtbar: Die Maschine stellt Bedeutungszusammenhänge her. Der Mensch prüft, widerspricht, interpretiert und trägt die Verantwortung.